Vaka çalışması · Ar-Ge
LLM Studio
macOS için yerel öncelikli, çoklu ajan yapay zekâ çalışma ortamı. Kurumsal yapay zekâ işlerine taşıdığımız teknikleri burada geliştirip ölçüyoruz: sağlayıcı yönlendirme, bilgi erişimi, ajan denetimi ve token ekonomisi.
Kısaca
- Durum
- Ar-Ge; şirket içinde her gün kullanılıyor
- Platform
- Yerel API çekirdekli macOS masaüstü uygulaması
- Başlangıç
- Temmuz 2026
- Teknoloji
- Python, FastAPI, SQLite, React, TypeScript, Tauri (Rust), Swift
Gerçek ekranlar
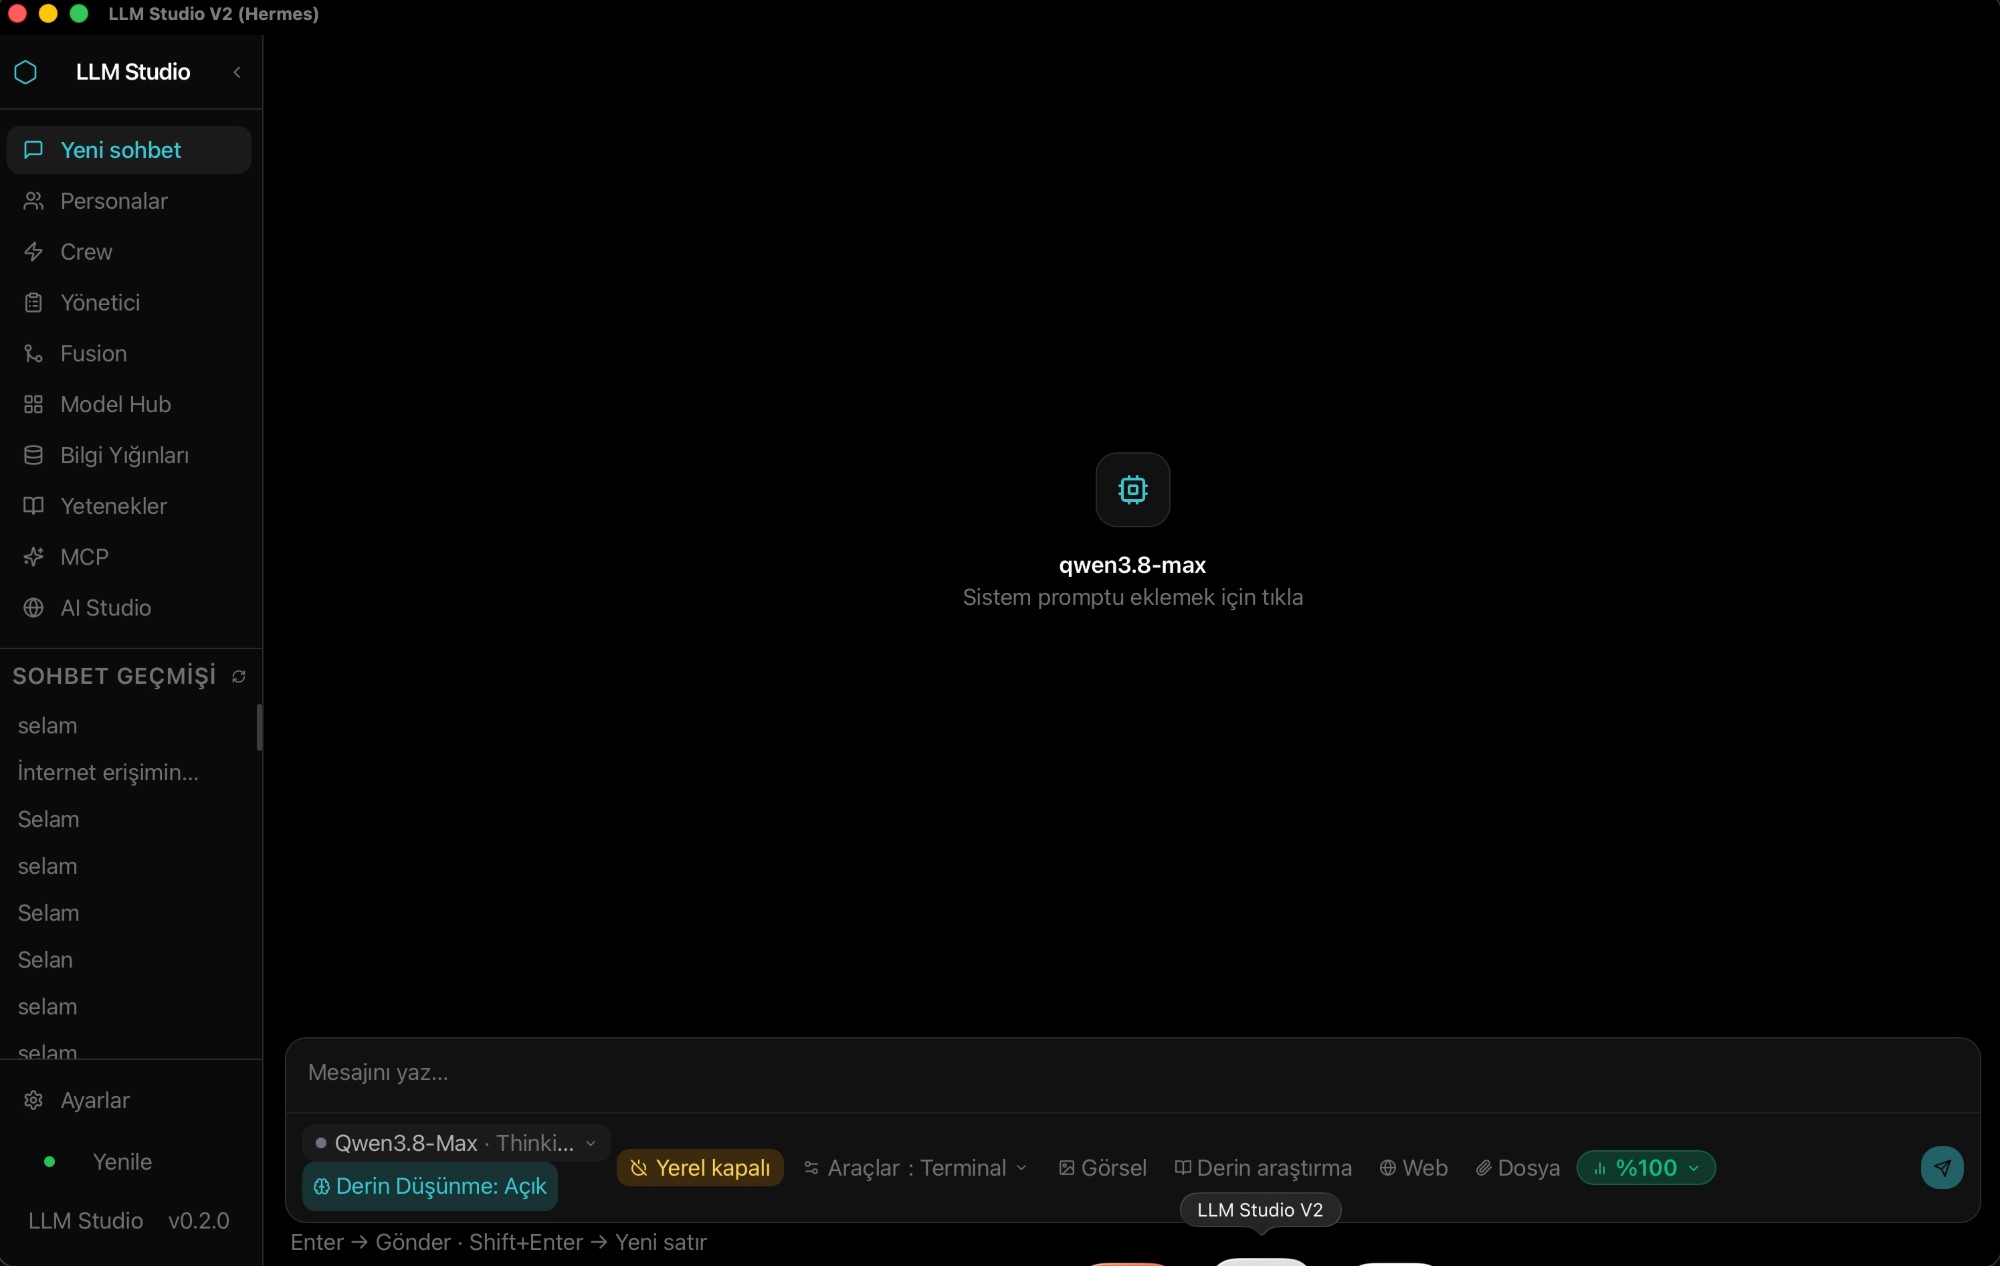
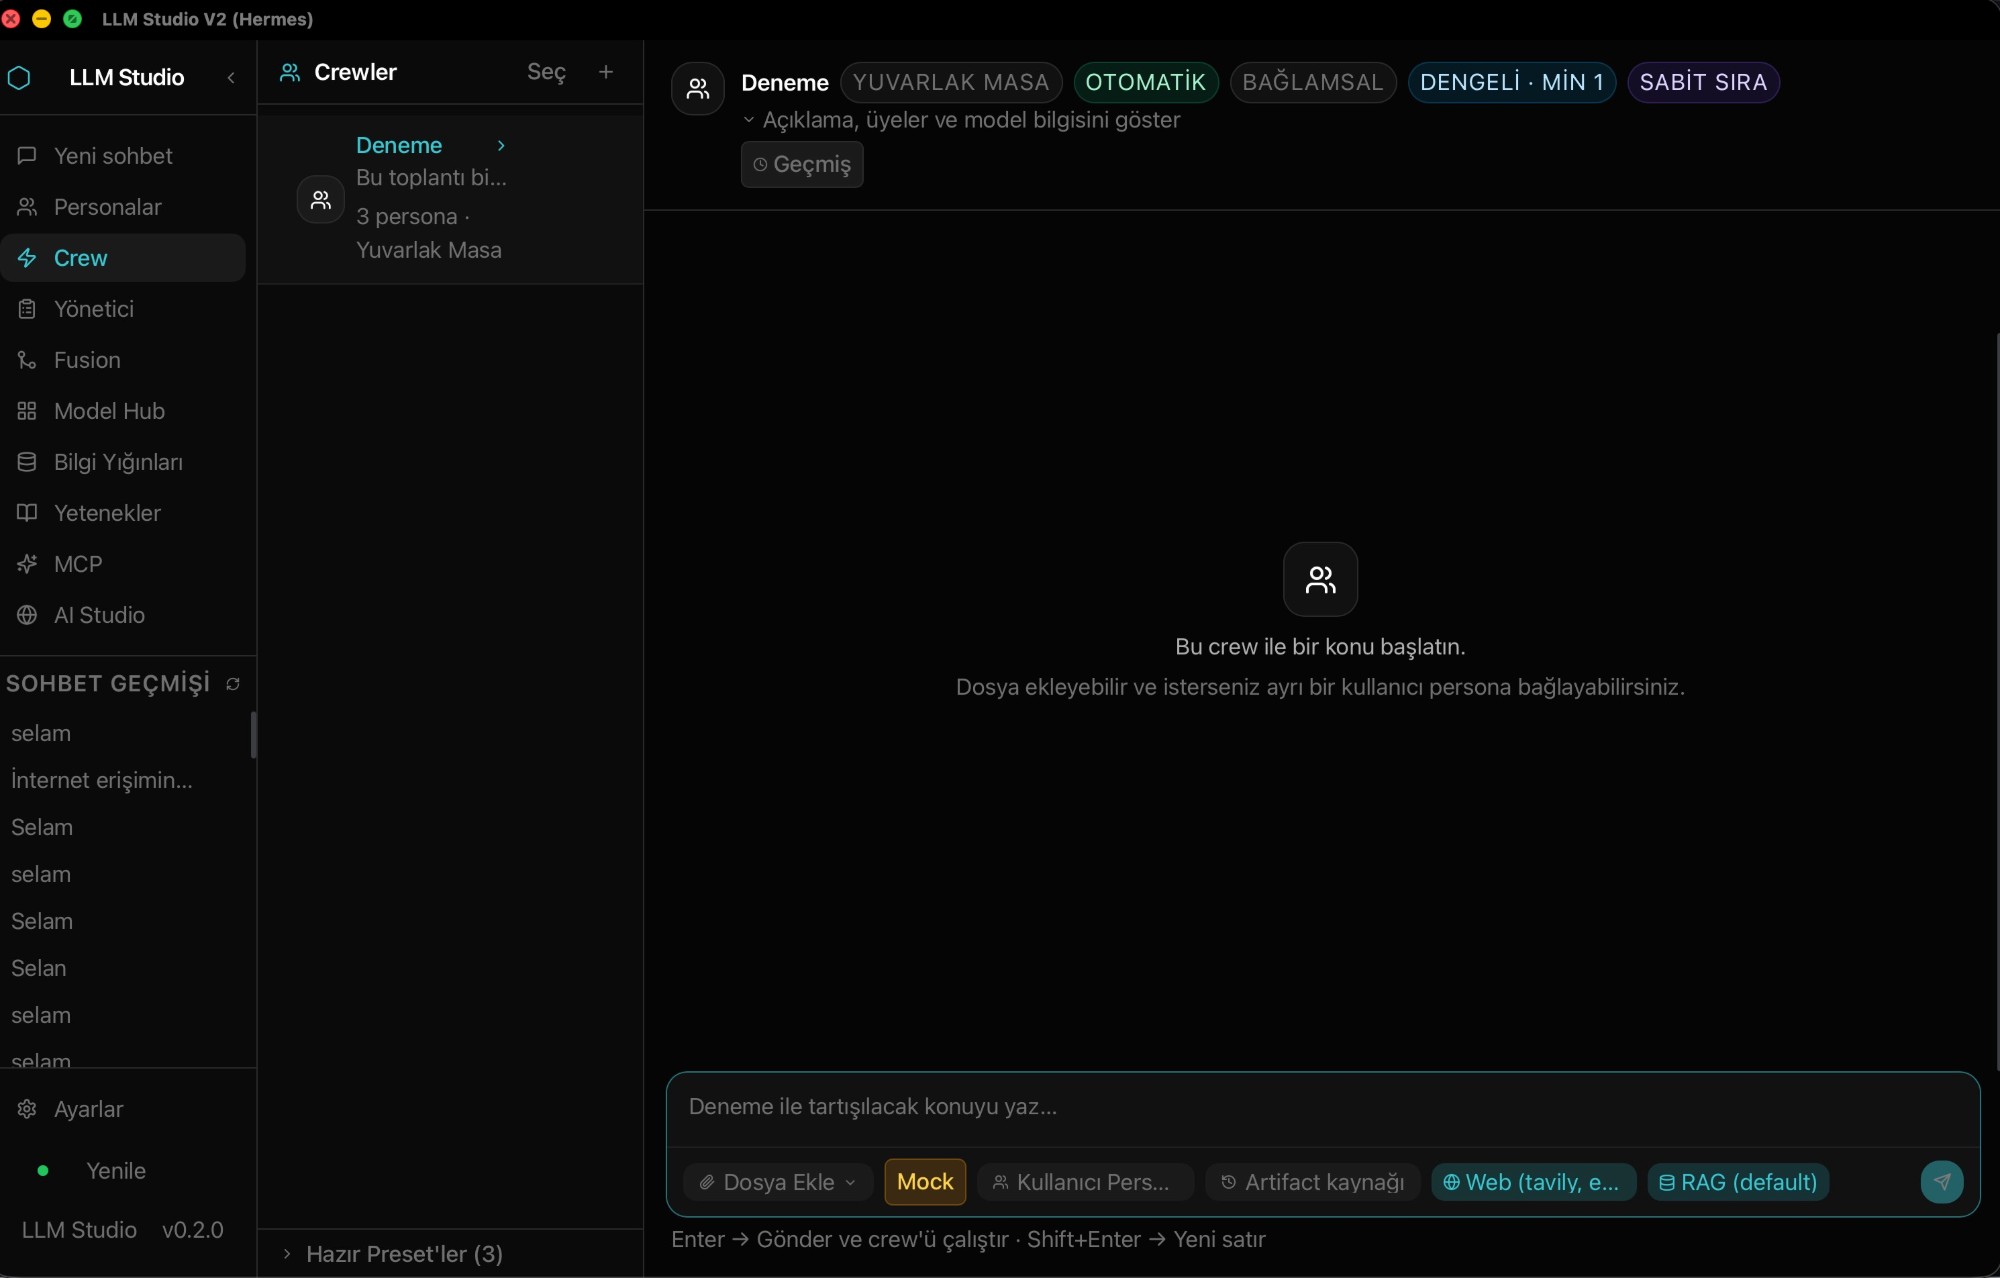
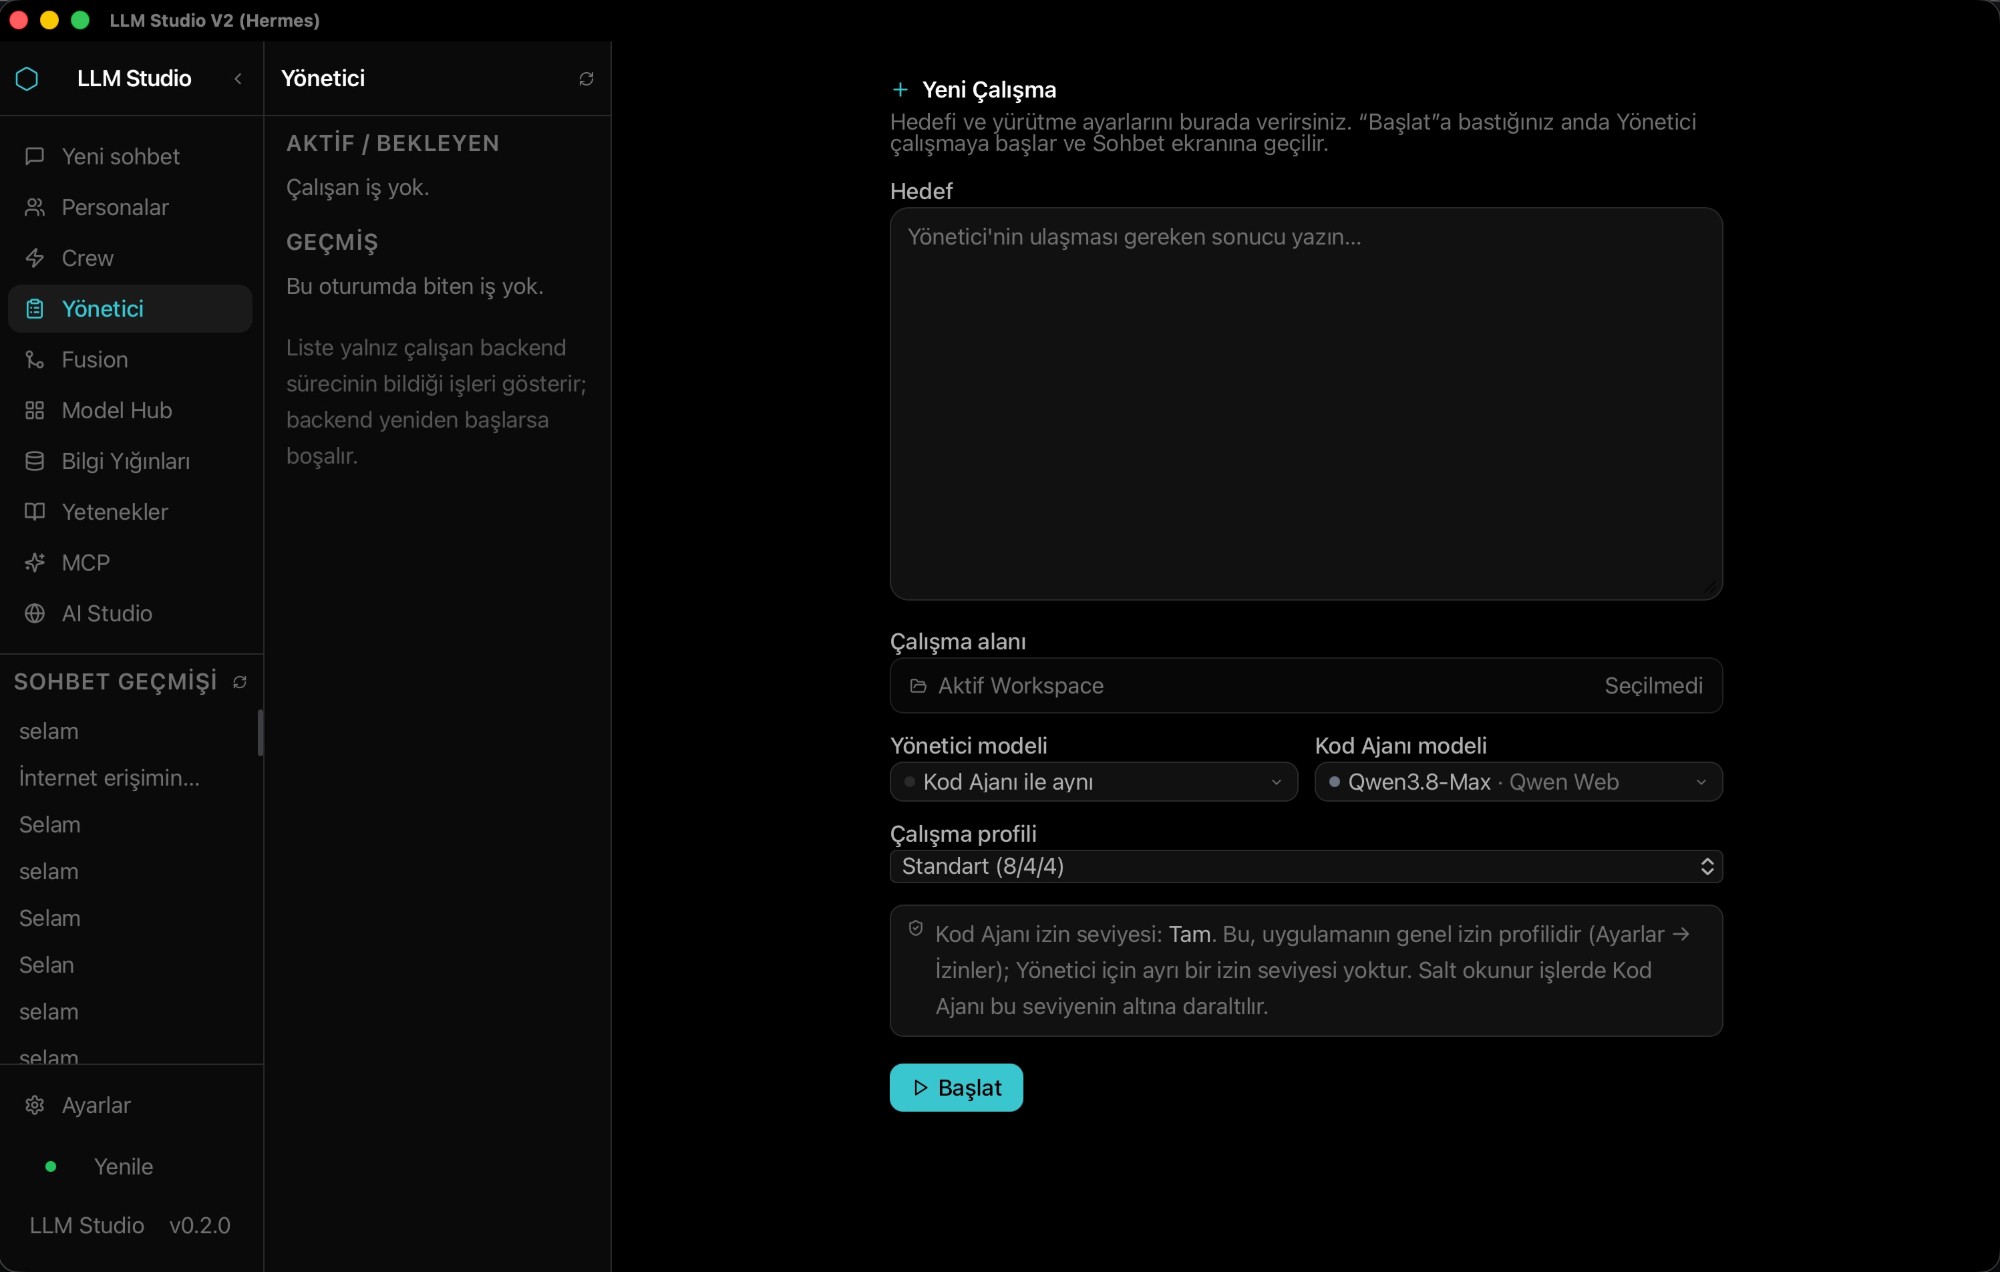
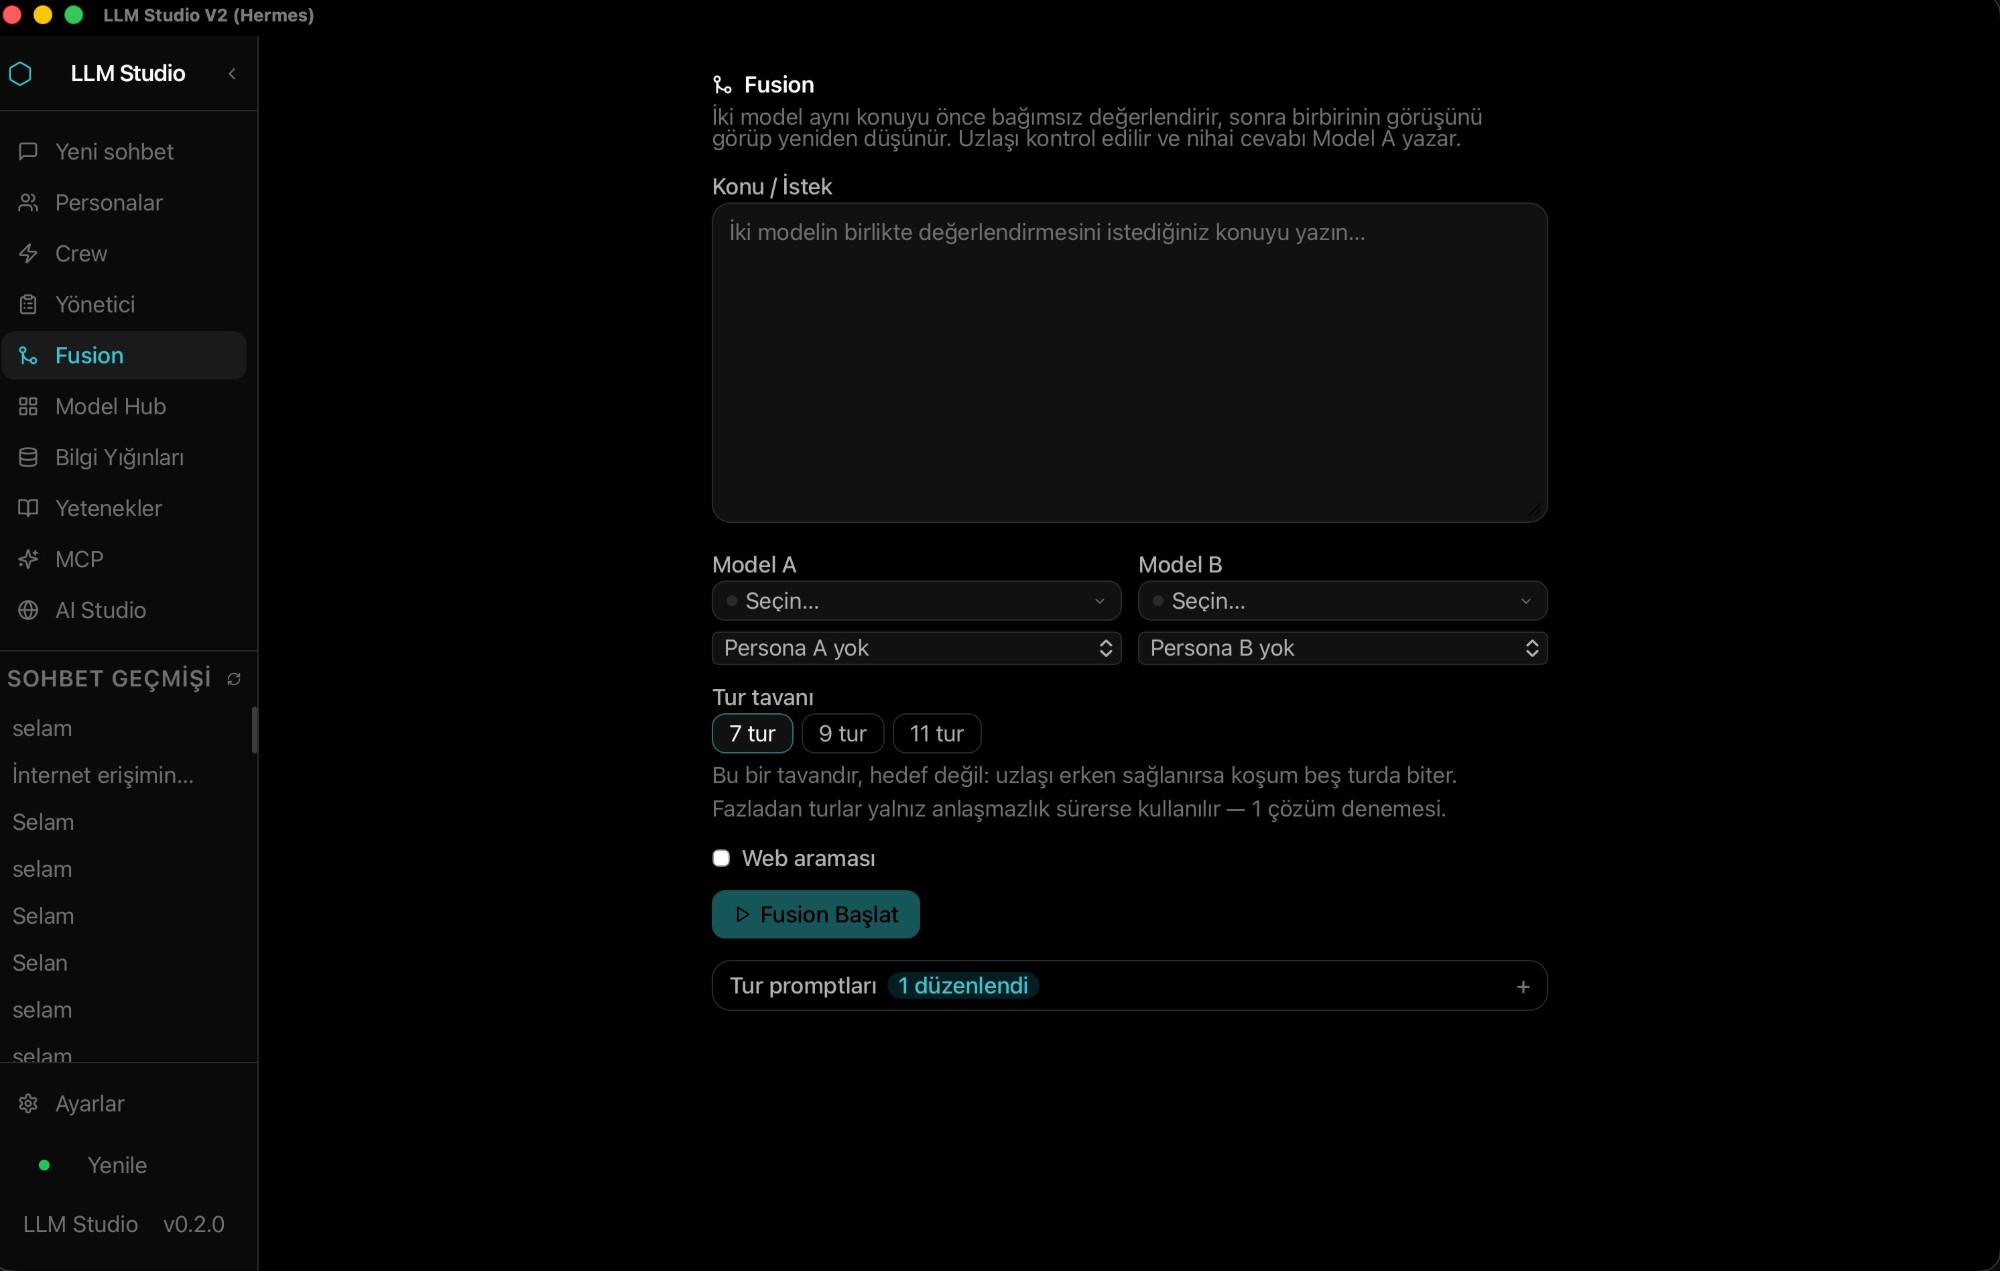
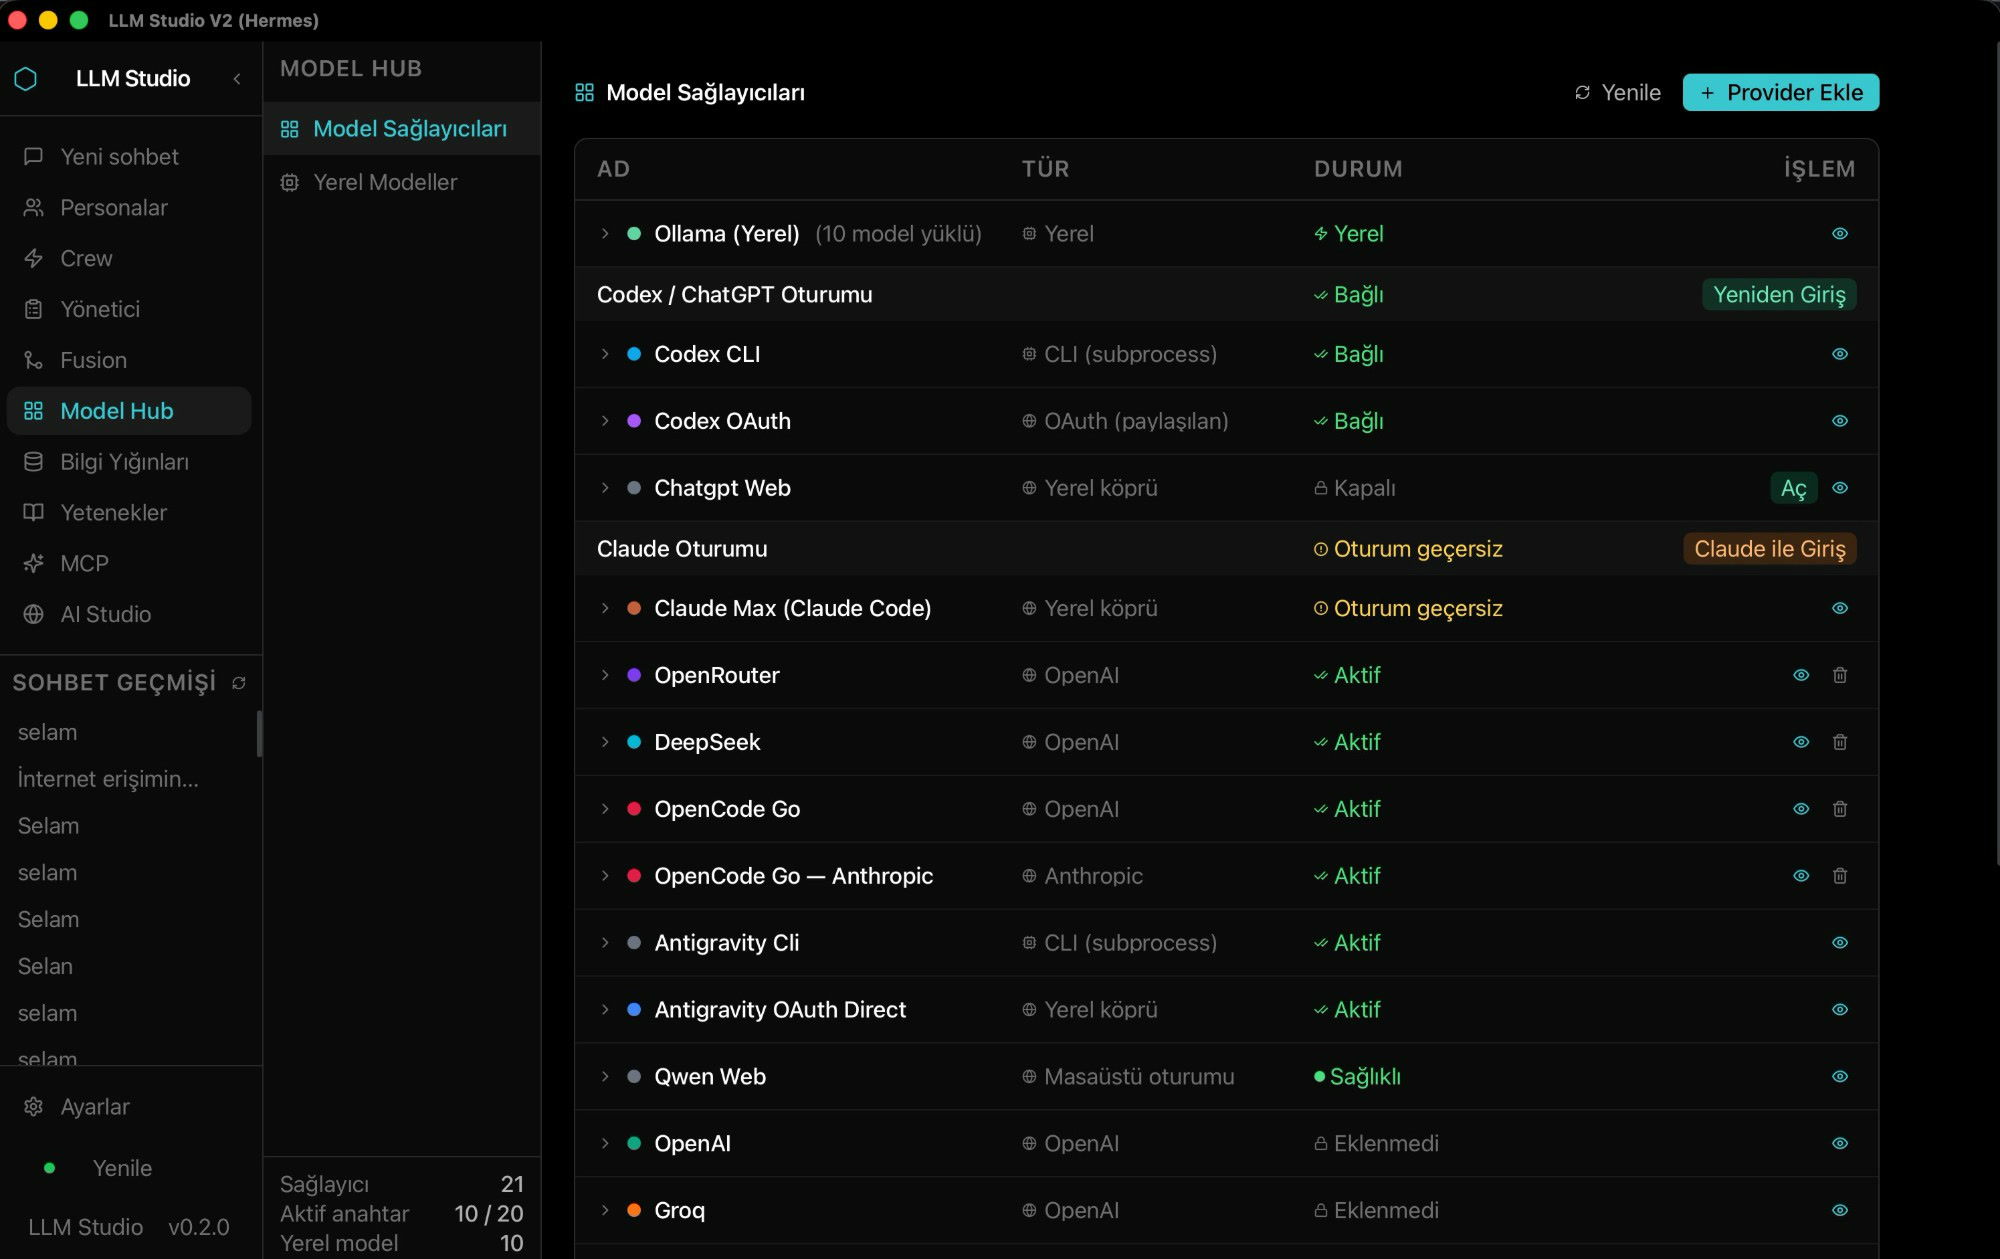
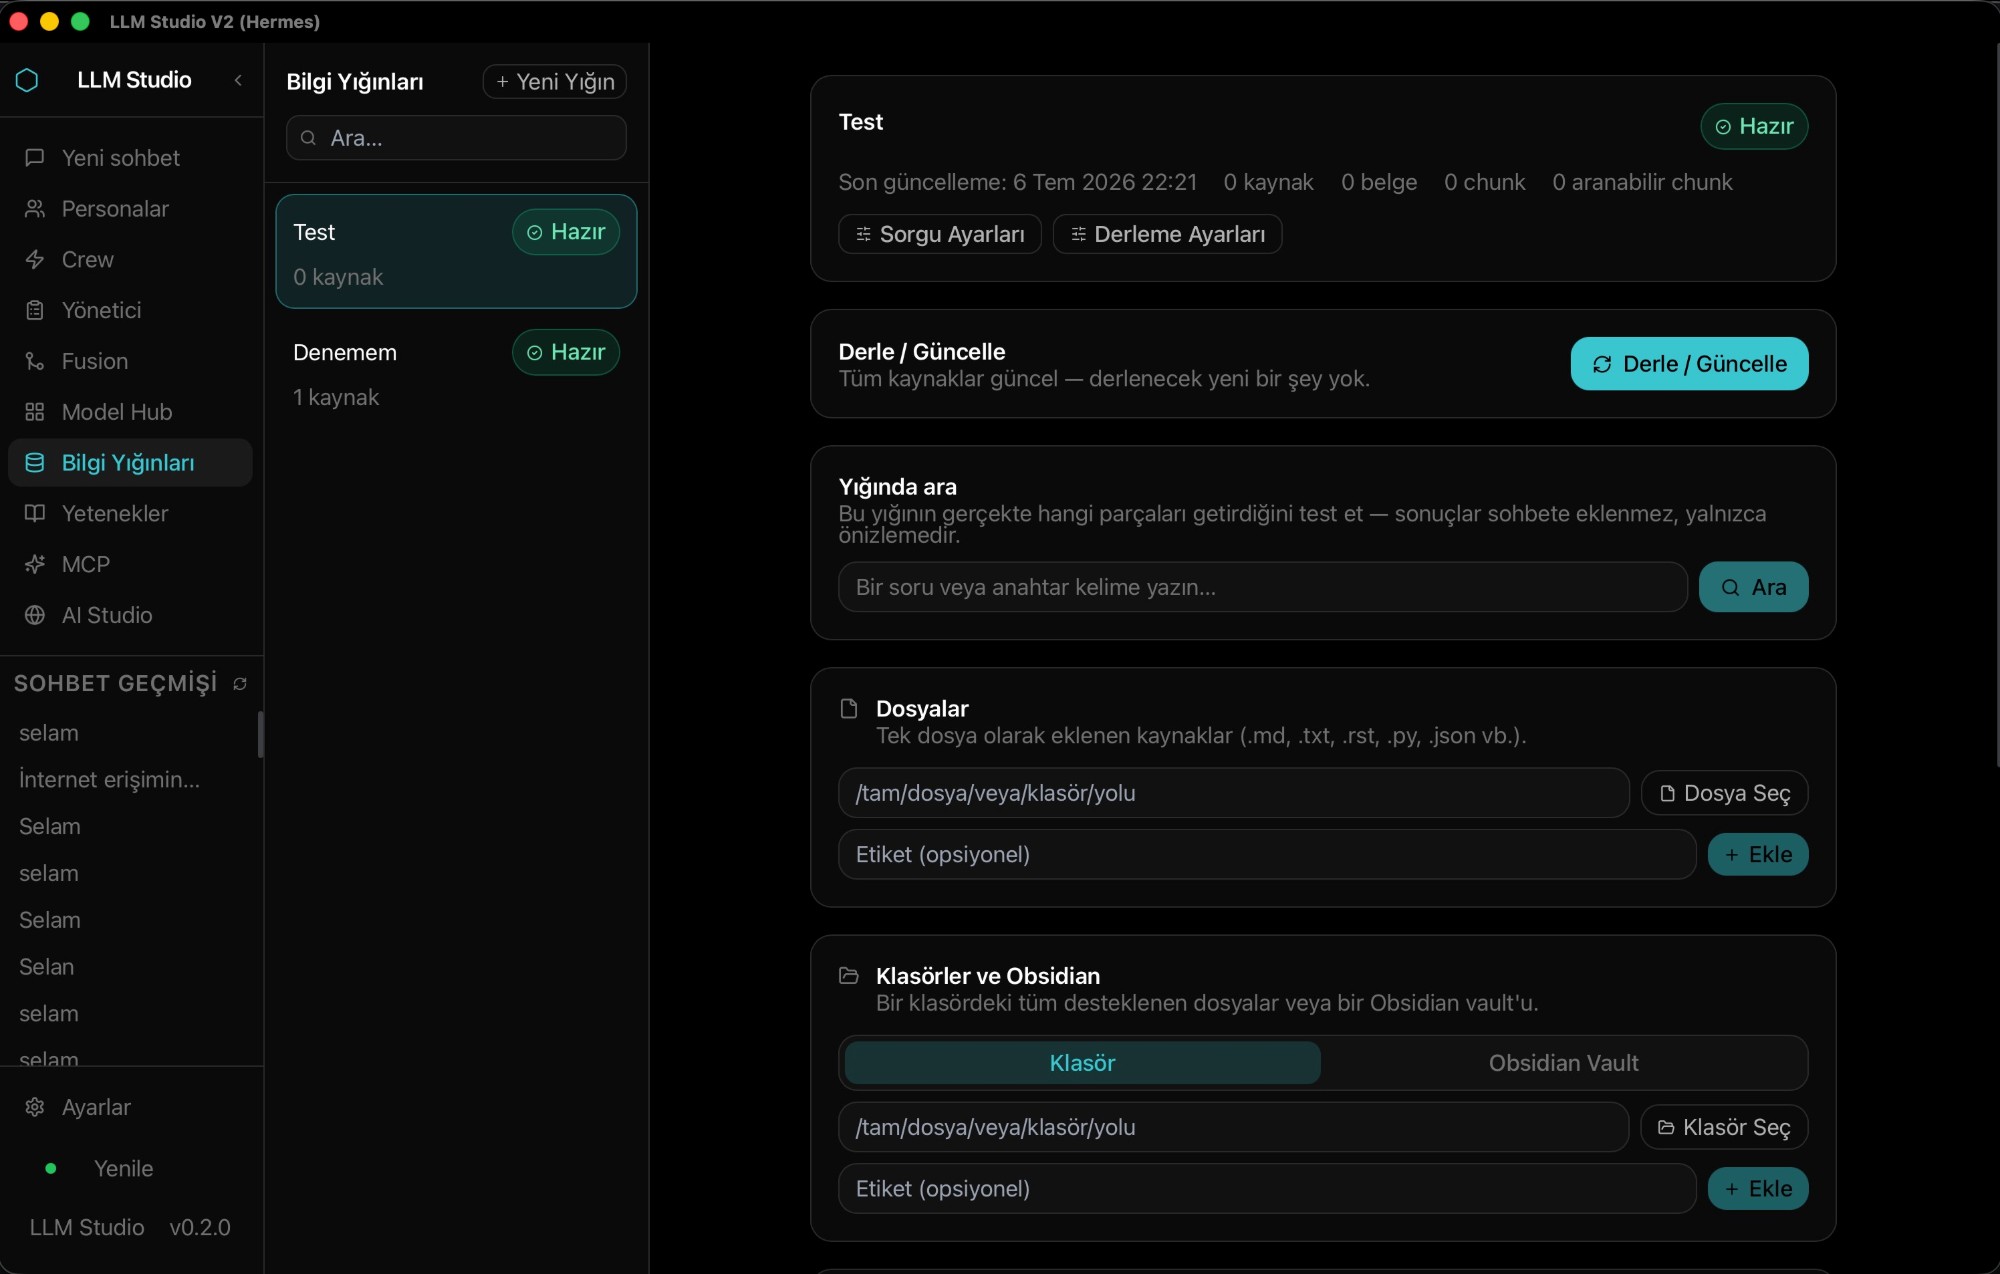
Neden var
Birçok ajan çerçevesi yardımcı model çağrılarını denetimsiz çalıştırır ve her istekte modele bütün araç kataloğunu verir. Tokenların gerçekte nereye gittiğini ölçmek ve her model çağrısının hesabının tutulduğu, her araç seçiminin bilinçli yapıldığı bir sistem kurmak istedik.
Mimari
- Masaüstü kabuğuTauri penceresi, React arayüzü
- Yerel APIAkışlı yanıtlarla FastAPI
- ÇekirdekPersonalar, ekipler, bilgi erişimi, politikalar
- SağlayıcılarTek arayüz arkasında yerel ve bulut modelleri
Bütün mantık çekirdektedir ve arayüz olmadan çalışır: aynı işlevler komut satırından ve Model Context Protocol (MCP) üzerinden araç olarak da kullanılabilir.
Yetenekler
- Deterministik sistem istemi derlemesi ve yetki politikalarıyla persona çalışma zamanı.
- Ekip motoru: kör sıralı ve yuvarlak masa çoklu ajan modları; hakem değerlendirmesi ve kalite eşiğiyle.
- Hibrit bilgi erişimi: karşılıklı sıra birleştirmeyle (RRF) BM25 ve vektör araması, kaynaklı bağlam, adlandırılmış çalışma alanları.
- Sağlık denetimi, zaman aşımı ve çağrı başına token muhasebesiyle çok sağlayıcılı katman.
- Politika, dayanıklılık ve araç erişimi katmanlarıyla MCP kayıt sistemi.
- Yan etkili her eylemden önce onay ve değişiklik güvenliği kapıları.
- Swift ile yazılmış, denetim kaydı tutan yerel macOS erişilebilirlik ajanı.
Ölçülen sonuç
- aynı 25 görevde Hermes Agent'ın tokenına göre
- 0,25×
- son koşuda başarılı görev
- 25/25
- üç koşuda daha az token
- %68–77
Asıl kaldıraç: her istek niyetine göre tek bir uygun araca yönlendirilir; model bütün katalog yerine tek bir araç şeması görür. Dosya okuma görevinde ilk çağrı 2.743 tokendan 1.308 tokena indi.
Görev başına ortalama toplam token
Görevlere göre (koşu başına ortalama token)
- Dosya okuma9.6342.1540,22×
- Dosya arama9.6632.5930,27×
- Dosya düzenleme15.0863.5330,23×
- Çok adımlı görev10.2122.8600,28×
- Satır sayma (terminal)9.5362.4990,26×
Ölçek ve kalite
- Temmuz 2026'dan beri commit
- 1.240+
- 818 test dosyasında otomatik test (Python ve TypeScript)
- 12.000+
- satır Python; ayrıca TypeScript, Rust ve Swift
- ~450 bin
Ölçümün kanıt paketi — koşu başına ham veri, SHA-256 özetleri ve iki tarafı yeniden hesaplayan betik — talep üzerine paylaşılır.
Aklınızda bir proje mi var?
Kısa bir açıklama gönderin. Önce karşılıklı NDA isterseniz, ayrıntıları paylaşmadan önce bizimkini gönderelim.